Domain der-link.de kaufen?
Wir ziehen mit dem Projekt
der-link.de um.
Sind Sie am Kauf der Domain
der-link.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain der-link.de kaufen?
Wie beeinflusst Data Mining die Geschäftsstrategie in verschiedenen Branchen und wie können Unternehmen von den Erkenntnissen profitieren, die durch Data Mining gewonnen werden?
Data Mining ermöglicht es Unternehmen, große Mengen an Daten zu analysieren und Muster sowie Trends zu identifizieren, die für ihre Branche relevant sind. In der Einzelhandelsbranche kann Data Mining beispielsweise dazu genutzt werden, um das Kaufverhalten der Kunden zu verstehen und personalisierte Marketingstrategien zu entwickeln. In der Gesundheitsbranche können durch Data Mining Krankheitsmuster erkannt und präventive Maßnahmen entwickelt werden. Unternehmen können von den Erkenntnissen, die durch Data Mining gewonnen werden, profitieren, indem sie fundierte Entscheidungen treffen, ihre Effizienz steigern und ihre Wettbewerbsfähigkeit stärken. Durch die Nutzung von Data Mining können Unternehmen auch neue Geschäftsmöglichkeiten identifizieren und innovative Produkte oder Dienstleistungen entwickeln, die den Bedürfnissen ihrer Kunden **
Wie kann Data Mining dazu beitragen, Muster und Erkenntnisse in großen Datensätzen zu entdecken? Welche Methoden und Techniken werden beim Data Mining eingesetzt?
Data Mining kann dabei helfen, versteckte Muster und Erkenntnisse in großen Datensätzen aufzudecken, indem Algorithmen angewendet werden, um die Daten zu analysieren und Zusammenhänge zu identifizieren. Zu den Methoden und Techniken, die beim Data Mining eingesetzt werden, gehören Clustering, Klassifizierung, Regression, Assoziationsanalyse und Anomalieerkennung. Durch diese Techniken können Unternehmen wertvolle Einblicke gewinnen und fundierte Entscheidungen treffen. **
Ähnliche Suchbegriffe für Cleve-Jürgen-Data-Mining
Top-Angebote
Produkte zum Begriff Cleve-Jürgen-Data-Mining:
-
Kaspersky Threat Data Feeds - Phishing URLKaspersky Threat Data Feeds – Phishing URL In der heutigen vernetzten Welt stellen Phishing-Angriffe eine der größten Cyberbedrohungen für Unternehmen und Privatpersonen dar. Cyberkriminelle nutzen bösartige Websites, um Benutzerdaten zu stehlen, vertrauliche Informationen auszuspionieren und schädliche Aktivitäten auszuführen. Um sich gegen diese Angriffe zu wappnen, benötigen Unternehmen kontinuierlich aktualisierte Informationen über gefährliche URLs. **Kaspersky Threat Data Feeds – Phishing URL** bietet eine umfassende und ständig aktualisierte Datenquelle über bekannte Phishing-URLs, die es Unternehmen ermöglicht, potenziell schädliche Websites zu identifizieren und ihre Systeme effektiv vor Phishing-Angriffen zu schützen. Überblick über Kaspersky Threat Data Feeds – Phishing URL Der **Kaspersky Threat Data Feeds – Phishing URL**-Dienst stellt Unternehmen eine stetig aktualisierte Datenbank über URLs zur Verfügung, die als Phishing-Websites identifiziert wurden. Diese Feeds umfassen Details über verdächtige und bösartige Websites, die darauf abzielen, Benutzerdaten zu stehlen oder Schadsoftware zu verbreiten. Durch die Integration dieser Informationen in bestehende Sicherheitslösungen können Unternehmen ihre Abwehrmechanismen stärken und die Wahrscheinlichkeit von Cyberangriffen erheblich verringern. Hauptfunktionen Umfassende Phishing-URL-Daten: Bereitstellung einer ständig aktualisierten Datenbank mit Phishing-URLs, die in Echtzeit Bedrohungen erkennen und blockieren hilft. Zusätzliche Bedrohungsinformationen: Zu jeder URL werden relevante Details wie Kategorie, Bedrohungslevel und geografische Herkunft geliefert. Nahtlose Integration: Einfache Implementierung der Datenfeeds in bestehende SIEM-Systeme, Firewalls, Web-Gateways und andere Sicherheitssysteme. Minimierung von Fehlalarmen: Durch die Bereitstellung präziser Bedrohungsdaten werden Fehlalarme reduziert und die Effizienz des Sicherheitsteams gesteigert. Erkennung und Blockierung in Echtzeit: Proaktive Abwehrmaßnahmen gegen Bedrohungen, bevor sie in das System eindringen können. Vorteile für Ihr Unternehmen Erhöhter Schutz vor Phishing: Durch den Zugang zu aktuellen Bedrohungsdaten können Unternehmen schädliche Phishing-URLs schnell erkennen und blockieren. Optimierte Sicherheitsstrategie: Durch aktuelle Bedrohungsdaten können Unternehmen proaktive Sicherheitsmaßnahmen entwickeln und Sicherheitslücken schließen. Effizienzsteigerung: Die Reduzierung von Fehlalarmen ermöglicht es den Sicherheitsteams, sich auf echte Bedrohungen zu konzentrieren und schneller zu reagieren. Compliance und Sicherheitsstandards: Unterstützung bei der Einhaltung gesetzlicher und branchenspezifischer Sicherheitsanforderungen durch effektive Bedrohungserkennung. Skalierbare Lösung: Geeignet für Unternehmen jeder Größe und anpassbar an spezifische Sicherheitsanforderungen und -infrastrukturen. Integration und Kompatibilität Die Kaspersky Threat Data Feeds – Phishing URL sind so konzipiert, dass sie problemlos in bestehende IT-Sicherheitsinfrastrukturen integriert werden können. Sie unterstützen verschiedene Formate wie JSON, CSV und STIX, was die Implementierung in SIEM-Systeme, SOAR-Plattformen und andere Sicherheitslösungen erleichtert. Mit der flexiblen API-Integration können Unternehmen die Bedrohungsdaten genau an ihre Bedürfnisse anpassen und nahtlos in ihre Sicherheitsarchitekturen integrieren. Anwendungsfälle für Kaspersky Threat Data Feeds – Phishing URL Verhinderung von Identitätsdiebstahl: Durch Blockierung von Phishing-URLs können Unternehmen sicherstellen, dass Mitarbeiter und Kunden nicht auf gefälschte Websites zugreifen. Schutz vor Datendiebstahl: Phishing-Angriffe, die darauf abzielen, sensible Daten zu sammeln, können frühzeitig erkannt und verhindert werden. Erhöhung der Netzwerksicherheit: Durch die Identifizierung und Blockierung verdächtiger URLs kann das Unternehmensnetzwerk besser geschützt werden.20258,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Kaspersky Threat Data Feeds - Malicious URLKaspersky Threat Data Feeds – Malicious URL In einer zunehmend vernetzten Welt sind Bedrohungen durch schädliche URLs eine der größten Herausforderungen für Unternehmen, die ihre Netzwerksicherheit gewährleisten möchten. Schädliche URLs werden von Cyberkriminellen genutzt, um Phishing-Angriffe, Malware-Infektionen und andere bösartige Aktivitäten zu initiieren, die die Datensicherheit und Vertraulichkeit beeinträchtigen können. Mit **Kaspersky Threat Data Feeds – Malicious URL** erhalten Unternehmen Zugang zu einer stets aktuellen und umfassenden Datenbank mit potenziell gefährlichen URLs, die dabei hilft, solche Bedrohungen proaktiv zu erkennen und abzuwehren. Überblick über Kaspersky Threat Data Feeds – Malicious URL Der **Kaspersky Threat Data Feeds – Malicious URL**-Dienst stellt eine kontinuierlich aktualisierte Liste von URLs bereit, die in Verbindung mit schädlichen Aktivitäten stehen. Diese Daten können Unternehmen dabei unterstützen, ihre Sicherheitsmaßnahmen zu verstärken, indem sie sicherstellen, dass bösartige URLs erkannt und blockiert werden, bevor sie Schaden anrichten können. Die Datenfeeds umfassen Informationen über URLs, die für Phishing, Malware-Verbreitung, C&C-Server (Command and Control) und andere Bedrohungen bekannt sind. Die Daten werden von Kasperskys weltweitem Team von Cybersicherheitsexperten gesammelt und analysiert, um eine hohe Präzision und Relevanz sicherzustellen. Hauptfunktionen Umfassende Sammlung bösartiger URLs: Kontinuierliche Bereitstellung einer umfangreichen Datenbank schädlicher URLs, die regelmäßig aktualisiert wird. Präzise Bedrohungsinformationen: Jeder Eintrag wird durch zusätzliche Informationen ergänzt, wie z. B. Bedrohungstyp und Verbreitungsmuster. Nahtlose Integration: Einfache Integration der Daten in bestehende SIEM-Systeme, Firewalls, Web-Gateways und andere Sicherheitslösungen. Minimierung von Fehlalarmen: Durch die Bereitstellung spezifischer Bedrohungsdaten werden Fehlalarme reduziert und die Effizienz des Sicherheitsteams erhöht. Erkennung und Blockierung in Echtzeit: Proaktive Abwehrmaßnahmen gegen Bedrohungen, bevor diese Schaden anrichten können. Vorteile für Ihr Unternehmen Erhöhter Schutz vor Bedrohungen: Durch den Zugang zu aktuellen und präzisen Bedrohungsdaten können Unternehmen schädliche URLs frühzeitig erkennen und blockieren. Optimierte Sicherheitsstrategie: Die Nutzung aktueller Bedrohungsdaten unterstützt die Entwicklung proaktiver Sicherheitsmaßnahmen und die Minimierung potenzieller Angriffspunkte. Effizienzsteigerung: Durch die Reduzierung von Fehlalarmen können sich Sicherheitsteams auf tatsächliche Bedrohungen konzentrieren und schneller reagieren. Compliance und Sicherheitsstandards: Unterstützung bei der Einhaltung gesetzlicher und branchenspezifischer Sicherheitsanforderungen durch effektive Bedrohungserkennung. Skalierbare Lösung: Geeignet für Unternehmen jeder Größe und anpassbar an spezifische Sicherheitsanforderungen und -infrastrukturen. Integration und Kompatibilität Die Kaspersky Threat Data Feeds – Malicious URL sind so konzipiert, dass sie problemlos in bestehende IT-Sicherheitsinfrastrukturen integriert werden können. Sie unterstützen verschiedene Formate wie JSON, CSV und STIX, was die Implementierung in SIEM-Systeme, SOAR-Plattformen und andere Sicherheitslösungen erleichtert. Mit der flexiblen API-Integration können Unternehmen die Bedrohungsdaten genau an ihre Bedürfnisse anpassen und nahtlos in ihre Sicherheitsarchitekturen integrieren. Anwendungsfälle für Kaspersky Threat Data Feeds – Malicious URL Schutz vor Phishing-Angriffen: Identifizierung und Blockierung bekannter Phishing-Websites, um die Sicherheit der Benutzer zu gewährleisten. Verhinderung von Malware-Infektionen: Früherkennung von URLs, die für die Verbreitung von Malware bekannt sind, um Infektionen zu verhindern. Abwehr von C&C-Kommunikation: Blockiert die Kommunikation zwischen bösartiger Software und C&C-Servern und reduziert so das Risiko von Datendiebstahl und Netzwerkübernahme.35958,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter




-
Wie beeinflusst Data Mining die Bereiche der Wirtschaft, der Gesundheit und der Technologie und welche ethischen Überlegungen müssen bei der Nutzung von Data Mining-Techniken berücksichtigt werden?
Data Mining beeinflusst die Bereiche der Wirtschaft, Gesundheit und Technologie, indem es Unternehmen dabei hilft, Muster und Trends in großen Datenmengen zu identifizieren, um fundierte Geschäftsentscheidungen zu treffen, die Effizienz im Gesundheitswesen zu verbessern und innovative Technologien zu entwickeln. In der Wirtschaft ermöglicht Data Mining eine bessere Kundenanalyse, Prognosen und Risikobewertung, während im Gesundheitswesen die Analyse von Patientendaten zur personalisierten Medizin und zur Früherkennung von Krankheiten beiträgt. In der Technologiebranche unterstützt Data Mining die Entwicklung von Produkten und Dienstleistungen, die auf die Bedürfnisse der Verbraucher zugeschnitten sind. Bei der Nutzung von Data Mining-Techniken müssen ethische Überlegungen berücksicht **
-
Was sind mögliche Anwendungen von Data Mining in der heutigen Geschäftswelt?
Mögliche Anwendungen von Data Mining in der heutigen Geschäftswelt sind die Analyse von Kundenverhalten zur Personalisierung von Marketingstrategien, die Vorhersage von Trends und Entwicklungen auf dem Markt sowie die Identifizierung von Betrug und Risiken in Finanztransaktionen. Data Mining kann auch zur Optimierung von Geschäftsprozessen, zur Verbesserung der Kundenbindung und zur Steigerung der Effizienz in verschiedenen Unternehmensbereichen eingesetzt werden. **
-
Was sind die primären Methoden und Anwendungen des Data Mining?
Die primären Methoden des Data Mining sind Clustering, Klassifizierung, Regression und Assoziationsanalyse. Diese Methoden werden angewendet, um Muster, Trends und Beziehungen in großen Datenmengen zu identifizieren. Die Anwendungen des Data Mining umfassen Marketing, Finanzen, Gesundheitswesen, Telekommunikation und viele andere Branchen. **
-
Wie beeinflusst Data Mining die Bereiche der Wirtschaft, der Medizin und der Technologie und welche ethischen Überlegungen sollten bei der Anwendung von Data Mining in diesen Bereichen berücksichtigt werden?
Data Mining ermöglicht es Unternehmen, Muster und Trends in großen Datenmengen zu identifizieren, um fundierte Geschäftsentscheidungen zu treffen und ihre Effizienz zu steigern. In der Medizin kann Data Mining dazu beitragen, Krankheitsmuster zu erkennen, personalisierte Behandlungspläne zu entwickeln und die Patientenversorgung zu verbessern. In der Technologiebranche wird Data Mining verwendet, um das Nutzerverhalten zu analysieren, personalisierte Empfehlungen zu generieren und die Benutzererfahrung zu optimieren. Bei der Anwendung von Data Mining in diesen Bereichen müssen ethische Überlegungen berücksichtigt werden, um sicherzustellen, dass die Privatsphäre und die Rechte der Betroffenen geschützt werden. Es ist wichtig, transparent zu sein und die Datenverwendung klar zu kommunizieren, um **


Wie beeinflusst künstliche Intelligenz den Bereich der Informatik? Welche Rolle spielen Big Data und Data Mining in der Informatik?
Künstliche Intelligenz optimiert Prozesse in der Informatik, automatisiert Aufgaben und ermöglicht neue Anwendungen wie maschinelles Lernen. Big Data und Data Mining sind wichtige Werkzeuge in der Informatik, um große Datenmengen zu analysieren, Muster zu erkennen und fundierte Entscheidungen zu treffen. Sie spielen eine zentrale Rolle bei der Entwicklung von KI-Systemen und der Optimierung von Algorithmen. **
Ist der Apriori-Algorithmus dem maschinellen Lernen oder dem Data Mining zuzuordnen?
Der Apriori-Algorithmus ist dem Data Mining zuzuordnen. Er wird verwendet, um häufige Muster in großen Datensätzen zu entdecken, insbesondere in der Assoziationsanalyse. Obwohl er in einigen maschinellen Lernverfahren verwendet werden kann, liegt sein Hauptanwendungsbereich im Data Mining. **
Top-Angebote
Produkte zum Begriff Cleve-Jürgen-Data-Mining:
-
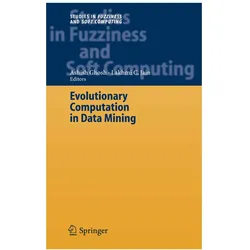
Evolutionary Computation in Data Mining, Fachbücher von Ashish GhoshData Mining (DM) besteht darin, interessante Erkenntnisse aus realen, grossen und komplexen Datensätzen zu extrahieren und ist der zentrale Schritt eines umfassenderen Prozesses, der als Wissensentdeckung aus Datenbanken (KDD) bezeichnet wird. Neben dem DM-Schritt, der Wissen aus Daten extrahiert, umfasst der KDD-Prozess mehrere Vorverarbeitungs- (oder Datenvorbereitungs-) und Nachbearbeitungsschritte (oder Wissensverfeinerung). Das Ziel der Methoden zur Datenvorverarbeitung besteht darin, die Daten so zu transformieren, dass die Anwendung eines oder mehrerer gegebener DM-Algorithmen erleichtert wird, während das Ziel der Methoden zur Wissensverfeinerung darin besteht, entdecktes Wissen zu validieren und zu verfeinern. Idealerweise sollte das entdeckte Wissen nicht nur genau, sondern auch verständlich und interessant für den Benutzer sein. Der gesamte Prozess ist sehr rechenintensiv. Die Idee, Wissen automatisch aus Datenbanken zu entdecken, ist eine sehr attraktive und herausfordernde Aufgabe, sowohl für die Wissenschaft als auch für die Industrie. Daher gibt es ein wachsendes Interesse an Data Mining in mehreren KI-bezogenen Bereichen, einschliesslich evolutionärer Algorithmen (EAs). Die Hauptmotivation für die Anwendung von EAs auf KDD-Aufgaben besteht darin, dass sie robuste und adaptive Suchmethoden sind, die eine globale Suche im Raum der Kandidatenlösungen, wie Regeln oder andere Formen der Wissensdarstellung, durchführen.94,10 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
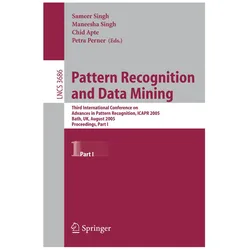
Pattern Recognition and Data Mining, Fachbücher von Maneesha Singh, Chid Apte et alDas Fachbuch "Pattern Recognition and Data Mining" von Maneesha Singh und Chid Apte bietet eine umfassende Einführung in die Techniken und Methoden der Mustererkennung und des Data Minings. Mit einem klar strukturierten Ansatz werden grundlegende Konzepte sowie fortgeschrittene Techniken behandelt, die für Studierende und Fachleute im Bereich Technik und IT von Bedeutung sind. Das Buch umfasst 694 Seiten und ist in englischer Sprache verfasst. Es richtet sich an Leser, die ein vertieftes Verständnis für die Analyse von Daten und die Erkennung von Mustern entwickeln möchten. Die erste Auflage, veröffentlicht im Jahr 2005, bietet sowohl theoretische Grundlagen als auch praktische Anwendungen, die in der heutigen datengetriebenen Welt von grosser Relevanz sind. Die kompakte Grösse von 15,5 cm in der Breite und 23,5 cm in der Höhe macht das Buch zudem handlich und leicht transportierbar.94,10 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie beeinflusst Data Mining die Geschäftsstrategie in verschiedenen Branchen und wie können Unternehmen von den Erkenntnissen profitieren, die durch Data Mining gewonnen werden?
Data Mining ermöglicht es Unternehmen, große Mengen an Daten zu analysieren und Muster sowie Trends zu identifizieren, die für ihre Branche relevant sind. In der Einzelhandelsbranche kann Data Mining beispielsweise dazu genutzt werden, um das Kaufverhalten der Kunden zu verstehen und personalisierte Marketingstrategien zu entwickeln. In der Gesundheitsbranche können durch Data Mining Krankheitsmuster erkannt und präventive Maßnahmen entwickelt werden. Unternehmen können von den Erkenntnissen, die durch Data Mining gewonnen werden, profitieren, indem sie fundierte Entscheidungen treffen, ihre Effizienz steigern und ihre Wettbewerbsfähigkeit stärken. Durch die Nutzung von Data Mining können Unternehmen auch neue Geschäftsmöglichkeiten identifizieren und innovative Produkte oder Dienstleistungen entwickeln, die den Bedürfnissen ihrer Kunden **
-
Wie kann Data Mining dazu beitragen, Muster und Erkenntnisse in großen Datensätzen zu entdecken? Welche Methoden und Techniken werden beim Data Mining eingesetzt?
Data Mining kann dabei helfen, versteckte Muster und Erkenntnisse in großen Datensätzen aufzudecken, indem Algorithmen angewendet werden, um die Daten zu analysieren und Zusammenhänge zu identifizieren. Zu den Methoden und Techniken, die beim Data Mining eingesetzt werden, gehören Clustering, Klassifizierung, Regression, Assoziationsanalyse und Anomalieerkennung. Durch diese Techniken können Unternehmen wertvolle Einblicke gewinnen und fundierte Entscheidungen treffen. **
-
Wie beeinflusst Data Mining die Bereiche der Wirtschaft, der Gesundheit und der Technologie und welche ethischen Überlegungen müssen bei der Nutzung von Data Mining-Techniken berücksichtigt werden?
Data Mining beeinflusst die Bereiche der Wirtschaft, Gesundheit und Technologie, indem es Unternehmen dabei hilft, Muster und Trends in großen Datenmengen zu identifizieren, um fundierte Geschäftsentscheidungen zu treffen, die Effizienz im Gesundheitswesen zu verbessern und innovative Technologien zu entwickeln. In der Wirtschaft ermöglicht Data Mining eine bessere Kundenanalyse, Prognosen und Risikobewertung, während im Gesundheitswesen die Analyse von Patientendaten zur personalisierten Medizin und zur Früherkennung von Krankheiten beiträgt. In der Technologiebranche unterstützt Data Mining die Entwicklung von Produkten und Dienstleistungen, die auf die Bedürfnisse der Verbraucher zugeschnitten sind. Bei der Nutzung von Data Mining-Techniken müssen ethische Überlegungen berücksicht **
-
Was sind mögliche Anwendungen von Data Mining in der heutigen Geschäftswelt?
Mögliche Anwendungen von Data Mining in der heutigen Geschäftswelt sind die Analyse von Kundenverhalten zur Personalisierung von Marketingstrategien, die Vorhersage von Trends und Entwicklungen auf dem Markt sowie die Identifizierung von Betrug und Risiken in Finanztransaktionen. Data Mining kann auch zur Optimierung von Geschäftsprozessen, zur Verbesserung der Kundenbindung und zur Steigerung der Effizienz in verschiedenen Unternehmensbereichen eingesetzt werden. **
Ähnliche Suchbegriffe für Cleve-Jürgen-Data-Mining
-
Kaspersky Threat Data Feeds - Phishing URLKaspersky Threat Data Feeds – Phishing URL In der heutigen vernetzten Welt stellen Phishing-Angriffe eine der größten Cyberbedrohungen für Unternehmen und Privatpersonen dar. Cyberkriminelle nutzen bösartige Websites, um Benutzerdaten zu stehlen, vertrauliche Informationen auszuspionieren und schädliche Aktivitäten auszuführen. Um sich gegen diese Angriffe zu wappnen, benötigen Unternehmen kontinuierlich aktualisierte Informationen über gefährliche URLs. **Kaspersky Threat Data Feeds – Phishing URL** bietet eine umfassende und ständig aktualisierte Datenquelle über bekannte Phishing-URLs, die es Unternehmen ermöglicht, potenziell schädliche Websites zu identifizieren und ihre Systeme effektiv vor Phishing-Angriffen zu schützen. Überblick über Kaspersky Threat Data Feeds – Phishing URL Der **Kaspersky Threat Data Feeds – Phishing URL**-Dienst stellt Unternehmen eine stetig aktualisierte Datenbank über URLs zur Verfügung, die als Phishing-Websites identifiziert wurden. Diese Feeds umfassen Details über verdächtige und bösartige Websites, die darauf abzielen, Benutzerdaten zu stehlen oder Schadsoftware zu verbreiten. Durch die Integration dieser Informationen in bestehende Sicherheitslösungen können Unternehmen ihre Abwehrmechanismen stärken und die Wahrscheinlichkeit von Cyberangriffen erheblich verringern. Hauptfunktionen Umfassende Phishing-URL-Daten: Bereitstellung einer ständig aktualisierten Datenbank mit Phishing-URLs, die in Echtzeit Bedrohungen erkennen und blockieren hilft. Zusätzliche Bedrohungsinformationen: Zu jeder URL werden relevante Details wie Kategorie, Bedrohungslevel und geografische Herkunft geliefert. Nahtlose Integration: Einfache Implementierung der Datenfeeds in bestehende SIEM-Systeme, Firewalls, Web-Gateways und andere Sicherheitssysteme. Minimierung von Fehlalarmen: Durch die Bereitstellung präziser Bedrohungsdaten werden Fehlalarme reduziert und die Effizienz des Sicherheitsteams gesteigert. Erkennung und Blockierung in Echtzeit: Proaktive Abwehrmaßnahmen gegen Bedrohungen, bevor sie in das System eindringen können. Vorteile für Ihr Unternehmen Erhöhter Schutz vor Phishing: Durch den Zugang zu aktuellen Bedrohungsdaten können Unternehmen schädliche Phishing-URLs schnell erkennen und blockieren. Optimierte Sicherheitsstrategie: Durch aktuelle Bedrohungsdaten können Unternehmen proaktive Sicherheitsmaßnahmen entwickeln und Sicherheitslücken schließen. Effizienzsteigerung: Die Reduzierung von Fehlalarmen ermöglicht es den Sicherheitsteams, sich auf echte Bedrohungen zu konzentrieren und schneller zu reagieren. Compliance und Sicherheitsstandards: Unterstützung bei der Einhaltung gesetzlicher und branchenspezifischer Sicherheitsanforderungen durch effektive Bedrohungserkennung. Skalierbare Lösung: Geeignet für Unternehmen jeder Größe und anpassbar an spezifische Sicherheitsanforderungen und -infrastrukturen. Integration und Kompatibilität Die Kaspersky Threat Data Feeds – Phishing URL sind so konzipiert, dass sie problemlos in bestehende IT-Sicherheitsinfrastrukturen integriert werden können. Sie unterstützen verschiedene Formate wie JSON, CSV und STIX, was die Implementierung in SIEM-Systeme, SOAR-Plattformen und andere Sicherheitslösungen erleichtert. Mit der flexiblen API-Integration können Unternehmen die Bedrohungsdaten genau an ihre Bedürfnisse anpassen und nahtlos in ihre Sicherheitsarchitekturen integrieren. Anwendungsfälle für Kaspersky Threat Data Feeds – Phishing URL Verhinderung von Identitätsdiebstahl: Durch Blockierung von Phishing-URLs können Unternehmen sicherstellen, dass Mitarbeiter und Kunden nicht auf gefälschte Websites zugreifen. Schutz vor Datendiebstahl: Phishing-Angriffe, die darauf abzielen, sensible Daten zu sammeln, können frühzeitig erkannt und verhindert werden. Erhöhung der Netzwerksicherheit: Durch die Identifizierung und Blockierung verdächtiger URLs kann das Unternehmensnetzwerk besser geschützt werden.20258,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Kaspersky Threat Data Feeds - Malicious URLKaspersky Threat Data Feeds – Malicious URL In einer zunehmend vernetzten Welt sind Bedrohungen durch schädliche URLs eine der größten Herausforderungen für Unternehmen, die ihre Netzwerksicherheit gewährleisten möchten. Schädliche URLs werden von Cyberkriminellen genutzt, um Phishing-Angriffe, Malware-Infektionen und andere bösartige Aktivitäten zu initiieren, die die Datensicherheit und Vertraulichkeit beeinträchtigen können. Mit **Kaspersky Threat Data Feeds – Malicious URL** erhalten Unternehmen Zugang zu einer stets aktuellen und umfassenden Datenbank mit potenziell gefährlichen URLs, die dabei hilft, solche Bedrohungen proaktiv zu erkennen und abzuwehren. Überblick über Kaspersky Threat Data Feeds – Malicious URL Der **Kaspersky Threat Data Feeds – Malicious URL**-Dienst stellt eine kontinuierlich aktualisierte Liste von URLs bereit, die in Verbindung mit schädlichen Aktivitäten stehen. Diese Daten können Unternehmen dabei unterstützen, ihre Sicherheitsmaßnahmen zu verstärken, indem sie sicherstellen, dass bösartige URLs erkannt und blockiert werden, bevor sie Schaden anrichten können. Die Datenfeeds umfassen Informationen über URLs, die für Phishing, Malware-Verbreitung, C&C-Server (Command and Control) und andere Bedrohungen bekannt sind. Die Daten werden von Kasperskys weltweitem Team von Cybersicherheitsexperten gesammelt und analysiert, um eine hohe Präzision und Relevanz sicherzustellen. Hauptfunktionen Umfassende Sammlung bösartiger URLs: Kontinuierliche Bereitstellung einer umfangreichen Datenbank schädlicher URLs, die regelmäßig aktualisiert wird. Präzise Bedrohungsinformationen: Jeder Eintrag wird durch zusätzliche Informationen ergänzt, wie z. B. Bedrohungstyp und Verbreitungsmuster. Nahtlose Integration: Einfache Integration der Daten in bestehende SIEM-Systeme, Firewalls, Web-Gateways und andere Sicherheitslösungen. Minimierung von Fehlalarmen: Durch die Bereitstellung spezifischer Bedrohungsdaten werden Fehlalarme reduziert und die Effizienz des Sicherheitsteams erhöht. Erkennung und Blockierung in Echtzeit: Proaktive Abwehrmaßnahmen gegen Bedrohungen, bevor diese Schaden anrichten können. Vorteile für Ihr Unternehmen Erhöhter Schutz vor Bedrohungen: Durch den Zugang zu aktuellen und präzisen Bedrohungsdaten können Unternehmen schädliche URLs frühzeitig erkennen und blockieren. Optimierte Sicherheitsstrategie: Die Nutzung aktueller Bedrohungsdaten unterstützt die Entwicklung proaktiver Sicherheitsmaßnahmen und die Minimierung potenzieller Angriffspunkte. Effizienzsteigerung: Durch die Reduzierung von Fehlalarmen können sich Sicherheitsteams auf tatsächliche Bedrohungen konzentrieren und schneller reagieren. Compliance und Sicherheitsstandards: Unterstützung bei der Einhaltung gesetzlicher und branchenspezifischer Sicherheitsanforderungen durch effektive Bedrohungserkennung. Skalierbare Lösung: Geeignet für Unternehmen jeder Größe und anpassbar an spezifische Sicherheitsanforderungen und -infrastrukturen. Integration und Kompatibilität Die Kaspersky Threat Data Feeds – Malicious URL sind so konzipiert, dass sie problemlos in bestehende IT-Sicherheitsinfrastrukturen integriert werden können. Sie unterstützen verschiedene Formate wie JSON, CSV und STIX, was die Implementierung in SIEM-Systeme, SOAR-Plattformen und andere Sicherheitslösungen erleichtert. Mit der flexiblen API-Integration können Unternehmen die Bedrohungsdaten genau an ihre Bedürfnisse anpassen und nahtlos in ihre Sicherheitsarchitekturen integrieren. Anwendungsfälle für Kaspersky Threat Data Feeds – Malicious URL Schutz vor Phishing-Angriffen: Identifizierung und Blockierung bekannter Phishing-Websites, um die Sicherheit der Benutzer zu gewährleisten. Verhinderung von Malware-Infektionen: Früherkennung von URLs, die für die Verbreitung von Malware bekannt sind, um Infektionen zu verhindern. Abwehr von C&C-Kommunikation: Blockiert die Kommunikation zwischen bösartiger Software und C&C-Servern und reduziert so das Risiko von Datendiebstahl und Netzwerkübernahme.35958,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Cleve, Jürgen: Data MiningData Mining , Datenanalyse für Künstliche Intelligenz , Luft- & Hydraulikfederung > Sportfederung , Auflage: 4. Auflage, Erscheinungsjahr: 20240506, Produktform: Kartoniert, Titel der Reihe: De Gruyter Studium##, Autoren: Cleve, Jürgen~Lämmel, Uwe, Auflage: 24004, Auflage/Ausgabe: 4. Auflage, Abbildungen: 176 b/w illustrations, 54 b/w tbl., Themenüberschrift: COMPUTERS / Data Processing, Keyword: Artificial Intelligence; Big Data; Data Mining; Machine Learning, Fachschema: Analyse / Datenanalyse~Datenanalyse~EDV / Theorie / Allgemeines~Data Mining (EDV)~Informatik~Intelligenz / Künstliche Intelligenz~KI~Künstliche Intelligenz - AI, Fachkategorie: Informationstechnik (IT), allgemeine Themen~Datenerfassung und -analyse~Data Mining~Praktische Anwendung für Informationstechnologien~Künstliche Intelligenz, Warengruppe: HC/Informatik, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Länge: 238, Breite: 167, Höhe: 21, Gewicht: 580, Produktform: Kartoniert, Genre: Mathematik/Naturwissenschaften/Technik/Medizin,79,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Urban Mining und kreislaufgerechtes Bauen.Urban Mining und kreislaufgerechtes Bauen. , Die Stadt als Rohstofflager. , Handschuhe, Mützen & Schwämme > Autopflege & Aufbereitung , Erscheinungsjahr: 20210527, Produktform: Leinen, Redaktion: Heisel, Felix~Hebel, Dirk E., Seitenzahl/Blattzahl: 208, Abbildungen: 140 Abbildungen und 11 Tabellen, Themenüberschrift: ARCHITECTURE / Design, Drafting, Drawing & Presentation, Keyword: Bauplanung; Nachhaltiges Bauen; Bebauung; Nutzung; Architektur; Allgemein; Versorgung; Abfall; Baumaterial; Recycling; Upcycling; Material; Wiederverwendung; Bauelement; Recyclingverfahren; Sekundärrohstoff; Rohstoffgewinnung; Kreislaufwirtschaft; Rückbau; Innovation; Modell; Stoffkreislauf; Architekten; Ingenieure; Planer; Bausachverständige; Architekturbüros; Planungsbüros; Bauämter; Kommunalplaner; Umweltingenieure, Fachschema: Architektur - Baukunst~Bau / Baukunst~Entwurf / Architektur~Bau / Hochbau~Hochbau, Fachkategorie: Architektur: berufliche Praxis~Hochbau und Baustoffe, Warengruppe: HC/Bau- und Umwelttechnik, Fachkategorie: Bauwerke: Gestaltung, Thema: Verstehen, Text Sprache: ger, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Fraunhofer Irb Stuttgart, Verlag: Fraunhofer Irb Stuttgart, Verlag: Fraunhofer IRB Verlag, Länge: 284, Breite: 236, Höhe: 23, Gewicht: 1012, Produktform: Gebunden, Genre: Mathematik/Naturwissenschaften/Technik/Medizin, Genre: Mathematik/Naturwissenschaften/Technik/Medizin, eBook EAN: 9783738805642, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0002, Tendenz: -1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel,65,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die primären Methoden und Anwendungen des Data Mining?
Die primären Methoden des Data Mining sind Clustering, Klassifizierung, Regression und Assoziationsanalyse. Diese Methoden werden angewendet, um Muster, Trends und Beziehungen in großen Datenmengen zu identifizieren. Die Anwendungen des Data Mining umfassen Marketing, Finanzen, Gesundheitswesen, Telekommunikation und viele andere Branchen. **
-
Wie beeinflusst Data Mining die Bereiche der Wirtschaft, der Medizin und der Technologie und welche ethischen Überlegungen sollten bei der Anwendung von Data Mining in diesen Bereichen berücksichtigt werden?
Data Mining ermöglicht es Unternehmen, Muster und Trends in großen Datenmengen zu identifizieren, um fundierte Geschäftsentscheidungen zu treffen und ihre Effizienz zu steigern. In der Medizin kann Data Mining dazu beitragen, Krankheitsmuster zu erkennen, personalisierte Behandlungspläne zu entwickeln und die Patientenversorgung zu verbessern. In der Technologiebranche wird Data Mining verwendet, um das Nutzerverhalten zu analysieren, personalisierte Empfehlungen zu generieren und die Benutzererfahrung zu optimieren. Bei der Anwendung von Data Mining in diesen Bereichen müssen ethische Überlegungen berücksichtigt werden, um sicherzustellen, dass die Privatsphäre und die Rechte der Betroffenen geschützt werden. Es ist wichtig, transparent zu sein und die Datenverwendung klar zu kommunizieren, um **
-
Wie beeinflusst künstliche Intelligenz den Bereich der Informatik? Welche Rolle spielen Big Data und Data Mining in der Informatik?
Künstliche Intelligenz optimiert Prozesse in der Informatik, automatisiert Aufgaben und ermöglicht neue Anwendungen wie maschinelles Lernen. Big Data und Data Mining sind wichtige Werkzeuge in der Informatik, um große Datenmengen zu analysieren, Muster zu erkennen und fundierte Entscheidungen zu treffen. Sie spielen eine zentrale Rolle bei der Entwicklung von KI-Systemen und der Optimierung von Algorithmen. **
-
Ist der Apriori-Algorithmus dem maschinellen Lernen oder dem Data Mining zuzuordnen?
Der Apriori-Algorithmus ist dem Data Mining zuzuordnen. Er wird verwendet, um häufige Muster in großen Datensätzen zu entdecken, insbesondere in der Assoziationsanalyse. Obwohl er in einigen maschinellen Lernverfahren verwendet werden kann, liegt sein Hauptanwendungsbereich im Data Mining. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.